Thông tin liên hệ
- 036.686.3943
- admin@nguoicodonvn2008.info

Mô hình ngôn ngữ lớn (LLM) thường tạo ra những văn bản nghe có vẻ tự tin nhưng thực tế lại sai. RAG (Retrieval-Augmented Generation) khắc phục điều này bằng cách cung cấp cho LLM dữ liệu thực tế của bạn trước khi nó phản hồi.
Tóm tắt nhanh: Trong Bài học 3, bạn đã học về đầu ra có cấu trúc - nhận được JSON đáng tin cậy từ LLM. Nhưng nội dung của JSON đó chỉ tốt khi kiến thức của mô hình tốt. RAG giúp mô hình dựa trên dữ liệu của bạn để nó trả lời bằng sự thật, chứ không phải dữ liệu huấn luyện.
Quy trình gồm ba giai đoạn:
1. Lập chỉ mục: Chia tài liệu của bạn thành các đoạn, tạo ra những embedding (thể hiện bằng vector) và lưu trữ chúng trong cơ sở dữ liệu vector.
2. Truy xuất: Khi người dùng đặt câu hỏi, chuyển đổi câu hỏi thành embedding, tìm kiếm trong cơ sở dữ liệu vector các đoạn tương tự và trả về những kết quả phù hợp nhất.
3. Tạo: Gửi các đoạn đã truy xuất làm ngữ cảnh cho LLM cùng với câu hỏi của người dùng. LLM trả lời dựa trên ngữ cảnh được cung cấp, chứ không phải dữ liệu huấn luyện của nó.
Câu hỏi của người dùng → Nhúng → Tìm kiếm trong cơ sở dữ liệu vector → Top K khối
                                              ↓
Prompt hệ thông + Các khối + Câu hỏi → LLM → Câu trả lờiCách bạn chia tài liệu quyết định chất lượng truy xuất. Chia nhỏ sai cách và RAG của bạn sẽ bị hỏng ngay từ đầu.
Khuyến nghị về kích thước đoạn văn:
200-500 từ mỗi đoạn (điểm tối ưu được nghiên cứu chứng minh)
Quá nhỏ (< 100 từ): Các đoạn thiếu ngữ cảnh, câu trả lời không đầy đủ
Quá lớn (> 1000 từ): Các đoạn chứa quá nhiều chủ đề, độ chính xác truy xuất giảm
Chồng chéo: Thêm 20-30% chồng chéo giữa các đoạn liên tiếp. Nếu đoạn 1 gồm các từ 1-400, đoạn 2 bắt đầu từ từ 300, chứ không phải từ 401. Điều này ngăn ngừa mất thông tin ở phần ranh giới phân chia.
Chiến lược chia nhỏ tài liệu:
| Chiến lược | Cách hoạt động | Tốt nhất để |
Kích thước cố định | Tách mỗi N từ/token | Thiết lập nhanh, kích thước đồng nhất |
Ngữ nghĩa | Chia đoạn văn/phần | Duy trì sự mạch lạc của ý tưởng |
Đệ quy | Chia theo tiêu đề, sau đó theo đoạn văn, rồi theo câu | Tài liệu có cấu trúc (tài liệu hướng dẫn, cẩm nang) |
Nhận biết tài liệu | Tuân thủ cấu trúc tài liệu (tiêu đề, code block) | Tài liệu kỹ thuật |
Đối với hầu hết các trường hợp sử dụng của nhà phát triển, việc chia nhỏ đệ quy với tiêu đề phần làm ranh giới chính là hiệu quả nhất. Không bao giờ nên chia nhỏ các code block giữa chừng.
✅ Kiểm tra nhanh: Tài liệu codebase của bạn có một phần mang tên "Authentication" dài 2.000 từ. Bạn nên chia nhỏ nó như thế nào?
Câu trả lời: Sử dụng phương pháp chia nhỏ dựa trên tiêu đề. Chia nhỏ tại các tiêu đề phụ H2/H3 trong phần Authentication - "OAuth Flow" trở thành một khối, "API Key Management" trở thành một khối khác, "Session Handling" trở thành khối thứ ba. Mỗi chủ đề phụ vẫn được giữ nguyên. Bao gồm tiêu đề cha "Authentication" làm siêu dữ liệu trên mỗi khối để hệ thống truy xuất biết chúng có liên quan.
Truy xuất cơ bản: Nhúng câu hỏi của người dùng, tìm K khối tương tự nhất bằng độ tương đồng cosine. Phương pháp này hiệu quả với các câu hỏi trực tiếp nhưng gặp khó khăn với:
Các câu hỏi được diễn đạt lại (người dùng nói "làm thế nào để đăng nhập" nhưng tài liệu lại nói "xác thực")
Các câu hỏi đa bước (câu trả lời yêu cầu kết nối thông tin từ nhiều phần khác nhau)
Phủ định ("cái gì KHÔNG hỗ trợ SSO")
Các kỹ thuật truy xuất được cải tiến:
Tăng cường truy vấn: Tạo 3-5 câu trả lời diễn đạt lại câu hỏi của người dùng và truy xuất cho mỗi câu trả lời. Các cách diễn đạt khác nhau tương ứng với những từ vựng khác nhau trong tài liệu của bạn.
# Tạo các biến thể truy vấn
queries = generate_variants(user_question)
# ["How do I authenticate?", "Login process", "Auth setup guide",
#  "Getting started with authentication"]

# Truy xuất cho mỗi truy vấn, loại bỏ các kết quả trùng lặp
all_chunks = []
for query in queries:
    all_chunks.extend(retrieve(query, top_k=3))
unique_chunks = deduplicate(all_chunks)
Xếp hạng lại: Sau khi truy xuất ban đầu, sử dụng mô hình xếp hạng lại để chấm điểm lại các khối theo mức độ liên quan đến câu hỏi gốc. Điều này cải thiện đáng kể độ chính xác.
Lọc siêu dữ liệu: Gắn thẻ các khối bằng siêu dữ liệu (tài liệu nguồn, phần, ngày, danh mục) và lọc trước khi tìm kiếm ngữ nghĩa. "Câu hỏi về thanh toán" → chỉ tìm kiếm các khối liên quan đến thanh toán.
Bạn đã truy xuất được 5 khối liên quan. Bây giờ hãy lắp ráp chúng vào cửa sổ ngữ cảnh của LLM.
Quy tắc lắp ráp:
Liên quan nhất trước. Hiệu ứng "biến mất ở giữa chừng" có nghĩa là LLM ít chú ý đến nội dung ở giữa. Hãy đặt những đoạn thông tin quan trọng nhất ở đầu.
Bao gồm tài liệu tham khảo nguồn. Gắn thẻ nguồn cho mỗi đoạn thông tin: "[Từ: Hướng dẫn Xác thực, Mục 3.2]". Điều này giúp LLM trích dẫn nguồn và giúp bạn gỡ lỗi khi truy xuất.
Tuân thủ giới hạn token. Mỗi mô hình có một cửa sổ ngữ cảnh. Hãy chừa chỗ cho prompt hệ thống, câu hỏi của người dùng và việc tạo đầu ra. Cửa sổ ngữ cảnh 128K không có nghĩa là bạn nên điền đầy 127K bằng các đoạn thông tin.
Thêm hướng dẫn truy xuất. Hãy nói với LLM: "Chỉ trả lời dựa trên ngữ cảnh được cung cấp. Nếu ngữ cảnh không chứa câu trả lời, hãy nói 'Tôi không có thông tin về điều đó'."
✅ Kiểm tra nhanh: RAG của bạn truy xuất 10 đoạn thông tin với tổng cộng 8.000 token. Cửa sổ ngữ cảnh của bạn là 128K. Bạn có nên gửi cả 10 đoạn không?
Câu trả lời: Có lẽ là không. Càng nhiều đoạn thông tin càng nhiều nhiễu. Chỉ gửi 3-5 đoạn thông tin liên quan nhất. Các đoạn thông tin bổ sung sẽ làm loãng tín hiệu và tăng chi phí mà không cải thiện chất lượng tương xứng. Chất lượng ngữ cảnh quan trọng hơn số lượng.
RAG là một cách để tập hợp ngữ cảnh. Lĩnh vực rộng hơn — kỹ thuật ngữ cảnh — bao gồm:
Lịch sử hội thoại: Bao gồm các tin nhắn trước đó có liên quan (không phải tất cả)
Profile người dùng: Chèn thông tin cụ thể của người dùng (sở thích, lịch sử)
Kết quả công cụ: Kết quả từ các lệnh gọi hàm trước đó trong cuộc hội thoại
Hướng dẫn động: Điều chỉnh prompt hệ thống dựa trên nhiệm vụ hiện tại
Kỹ năng nằm ở việc quyết định ngữ cảnh nào mà mô hình cần để trả lời tốt - và loại trừ mọi thứ khác.
RAG dựa trên phản hồi của LLM trong dữ liệu của bạn - giảm ảo giác bằng cách cung cấp ngữ cảnh thực tế
Chia tài liệu thành các đoạn 200 - 500 từ với độ trùng lặp 20-30%; Tôn trọng cấu trúc tài liệu (không chia nhỏ các code block)
Cải thiện khả năng truy xuất bằng cách tăng cường truy vấn (nhiều cách diễn đạt khác nhau) và xếp hạng lại (chấm điểm lại theo mức độ liên quan)
Tập hợp ngữ cảnh với các đoạn văn bản liên quan nhất trước tiên - LLM ít chú ý đến nội dung ở giữa
Chất lượng ngữ cảnh quan trọng hơn số lượng - 3 đoạn văn bản có mức độ liên quan cao hơn 10 đoạn văn bản tầm thường
Yêu cầu LLM CHỈ trả lời từ ngữ cảnh được cung cấp để ngăn chặn trường hợp dự phòng ảo giác
Nguồn tin: Quantrimang.com
Ý kiến bạn đọc
Những tin mới hơn
 Hướng dẫn tạo slide thuyết trình bằng ChatGPT (04/05/2026)
 Thiết kế prompt: Kỹ năng cần thiết cho những nhà phát triển (04/05/2026)
 Hướng dẫn tạo giọng đọc lồng tiếng cho slide bài giảng (04/05/2026)
 Xây dựng Voice Agent của riêng bạn (04/05/2026)
 Cách cải thiện hiệu suất Claude Code bằng testing tự động (05/05/2026)
 Claude Design là gì? Công cụ thiết kế AI mới của Anthropic hoạt động ra sao (05/05/2026)
 Hướng dẫn tạo ảnh đồng nhất nhân vật cho bài thơ bằng Qwen AI (05/05/2026)
 Prompt tự động hóa soạn giáo án với Claude AI (05/05/2026)
 Prompt tạo ảnh tranh vẽ dễ thương, tranh vẽ con nít AI (05/05/2026)
 Prompt tạo ảnh Tổng kết năm học bằng ChatGPT (05/05/2026)
Những tin cũ hơn
 Sử dụng chế độ Học tập Gemini triển khai hình ảnh trực quan khái niệm (04/05/2026)
 Hướng dẫn thiết kế ý tưởng và cấu trúc dàn ý bằng Gemini (04/05/2026)
 10 Prompt biến NotebookLM thành trợ lý nghiên cứu đỉnh cao (04/05/2026) Cách cải thiện hiệu suất Claude Code bằng testing tự động (04/05/2026)
 Tạo tranh vẽ dễ thương từ ảnh bằng AI (04/05/2026)
 Skills trong Chrome là gì? Cách biến prompt AI thành công cụ “1 click” cực tiện lợi (03/05/2026)
 5 Python decorator giúp viết code AI sạch và dễ kiểm soát hơn (03/05/2026)
 Cách tạo và xuất file Microsoft Office trực tiếp từ đoạn chat với Gemini (03/05/2026)
 Cách xây dựng workflow LLM với Promptflow và OpenAI (có đánh giá, tracing) (03/05/2026)
 Cách khắc phục sự cố và những phương pháp tốt nhất trong Claude Dispatch (01/05/2026)
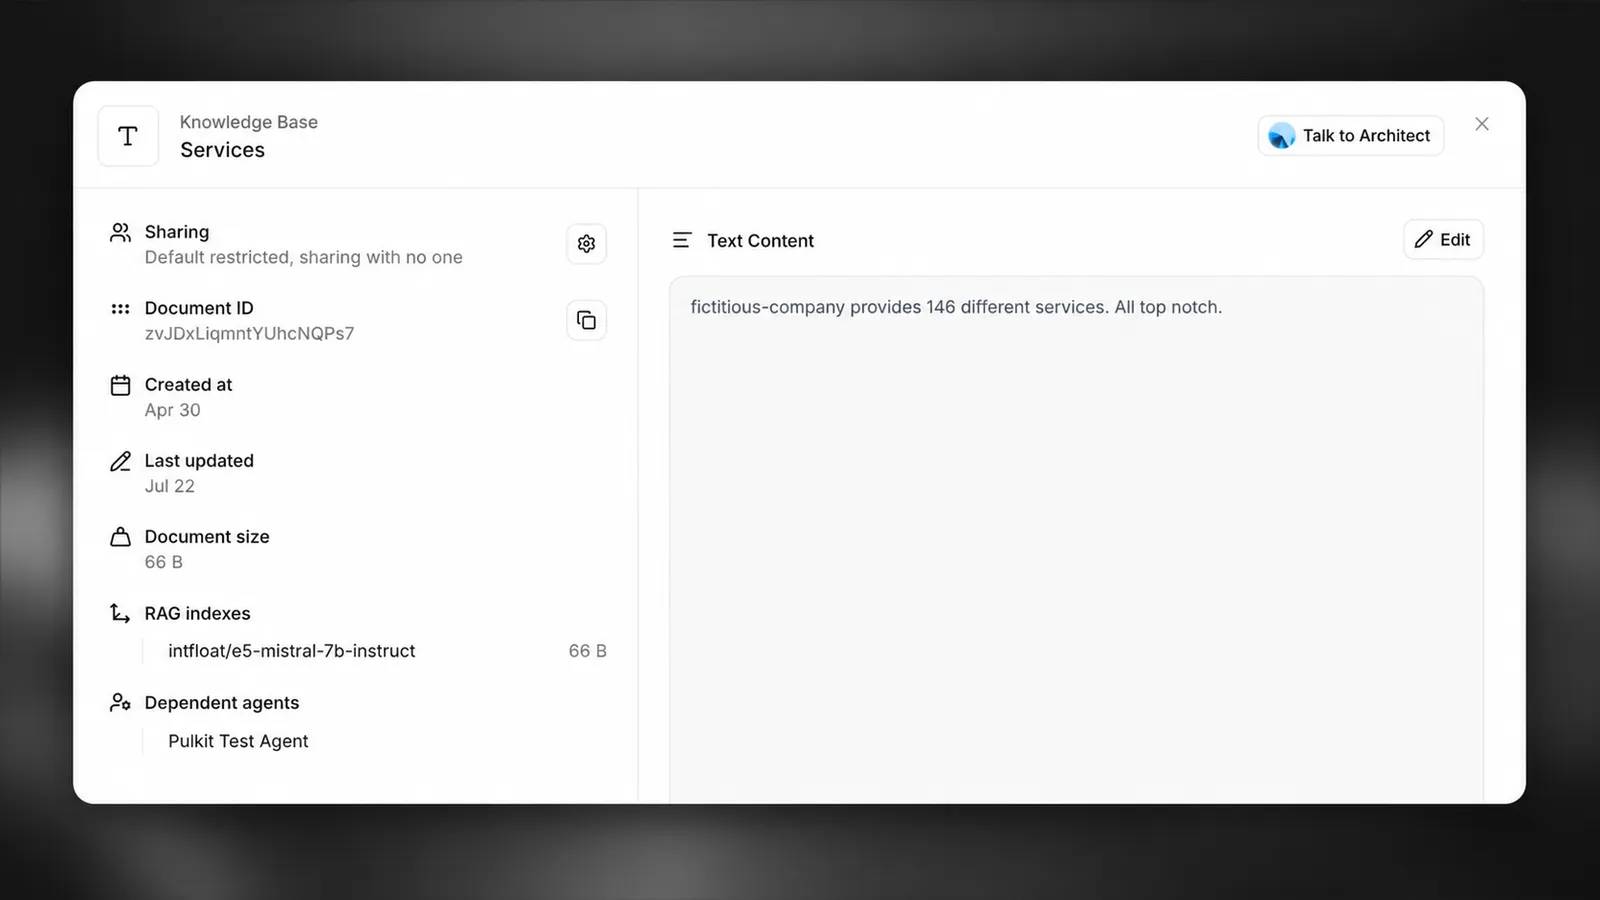 Quản lý tài liệu trong kho kiến thức ElevenAgents
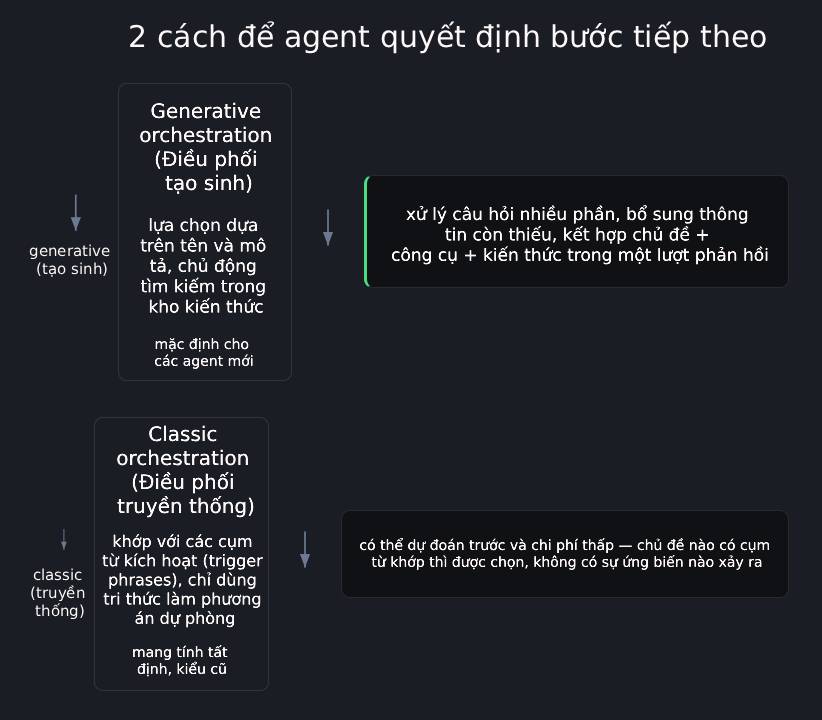 Generative Orchestration trong Copilot Studio: Cách agent đưa ra quyết định
 Cách chỉnh sửa và nâng cấp câu hỏi bằng Wayground AI
 Cách kết nối Claude với Gamma tạo website, slide thuyết trình
 Hướng dẫn lọc và xóa thư với Plugin Gmail trong ChatGPT
 11 trang web xem phim miễn phí vẫn hoạt động vào năm 2026
 Hướng dẫn dùng Wayground AI để tạo bài kiểm tra
 Hướng dẫn sử dụng Claude Slides tạo bài thuyết trình
 Cách dùng plugin Wayground với ChatGPT
 Ký tự khoảng trống FF là gì? Cách tạo tên trống trong Free Fire
 Nâng cao khả năng ElevenAgents bằng cơ sở kiến thức quy mô lớn sử dụng RAG
 100 ChatGPT/Gemini code giúp bạn chỉnh sửa ảnh như một chuyên gia
 Cách thêm nhiều tài khoản Gmail vào plugin Gmail trên ChatGPT
 Claude Design là gì? Cách dùng Claude Design thiết kế giao diện web
 Làm sao để không còn nhận được những câu trả lời chung chung khi nhập prompt vào Claude nữa?
 Hướng dẫn quản lý và ngắt kết nối ứng dụng trên ChatGPT
 Hướng dẫn thiết lập thông báo giờ nghỉ trên Claude
 Cách viết chữ kiểu FB: chữ in đậm, chữ 𝒏𝒈𝒉𝒊𝒆̂𝒏𝒈, đổi font chữ Facebook
 Agent hỗ trợ nhiều giọng nói trong ElevenAgents
 Kết hợp các kỹ thuật tạo prompt để thực hiện dự án thực tế
 Cách lập trình chuyên nghiệp hơn, dễ dàng hơn với tính năng Tệp trên Grok
 Hướng dẫn cài đặt và sử dụng n8n trên Windows 11
 Công thức tính diện tích hình Elip
 Hướng dẫn ngắt kết nối ứng dụng trên ChatGPT
 Hướng dẫn tạo đoạn hội thoại cho topic trên Twee
 Bức tranh tổng quan về hỗ trợ khách hàng tích hợp AI
 Đừng chia sẻ ảnh cho đến khi bạn chạy kiểm tra siêu dữ liệu này!
 6 cách mở Computer/System Properties trong Windows 10
 Cách sửa lỗi There Are Currently No Power Options Available Windows
 Hướng dẫn 8 cách mở bàn phím ảo trên Windows 10